#LLM
LongCat-2.5 : un modèle multimodal de 1,6T paramètres

4Lire
HOPE : élagage de experts pour des MoE plus légers

5Lire
Benchmark Qwen 3.8 Flash Next sur Mac M4 Pro et M5 Pro (24 Go)
3Lire
Rumeurs sur les prochains modèles Gemma
3Lire
Un serveur local à 4x R9700 pour inférence multi-utilisateurs

4Lire
Quantifications GGUF d'Arete-27B publiées par Nous Research

3Lire
Mamba-1 et PyTorch 2.7.1 portés sur de vieux GPU NVIDIA sous Windows
3Lire
Intel Arc Pro B70 : moitié de la vitesse d'une RTX 5090 pour 1/5 du prix

4Lire
Kimi K3.1 Pro Coder compressé à 775 Go, testé sur un seul GPU

4Lire
Next-Concept Modeling : génération de texte grossière-vers-fine

3Lire
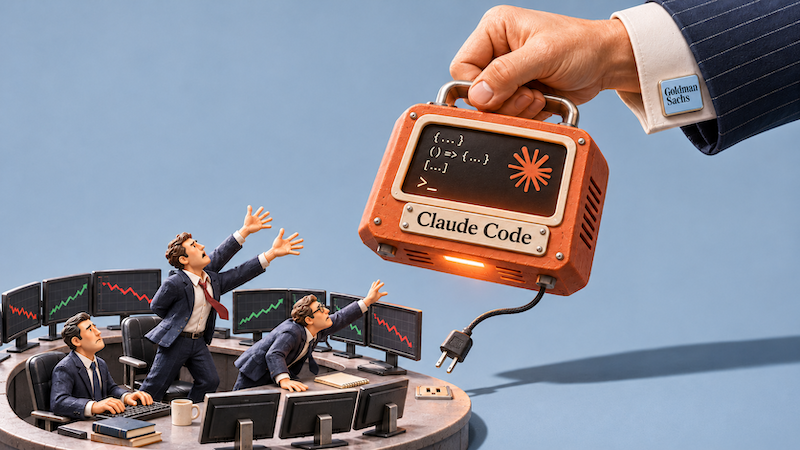
Goldman Sachs retire Claude Code à ses traders et banquiers
6Lire
Terminal-RSI-27B, un agent terminal basé sur Qwen

3Lire
Ce à quoi servent concrètement les modèles locaux
3Lire
Vidéo de motion graphics générée avec Qwen3.8 Flash Next en local

4Lire
Rumeur : la feuille de route de Moonshot Kimi jusqu'en 2027
3Lire
Drex Max v1.1 d'Artificial Analysis en tête d'un classement de décision

3Lire
Tencent publie Qwen3.8-27B-DSpine, un décodage spéculatif

4Lire
Quatre R9700 et deux RTX 3090 sur un seul slot x16 via switch PCIe

3Lire
Qwen3.5-0.8B exécuté en pur assembleur sur CPU

3Lire
Un petit modèle Qwen 0.8B fine-tuné pour traduire l'anglais en bash

3Lire
llama-modchip : un MoE 284B tournant sur CPU avec 64 Go de RAM
3Lire
Fin du groupe AI Frontiers de Microsoft Research
3Lire
Arete-27B, modèle texte populaire sur Hugging Face

3Lire
Gemini Omni 1.2 Flash : vidéos de 15 s, 30 % moins cher

6Lire